Logic Density Pruning: Mitigating Overthinking via Step-Level Chain of Thought Compression
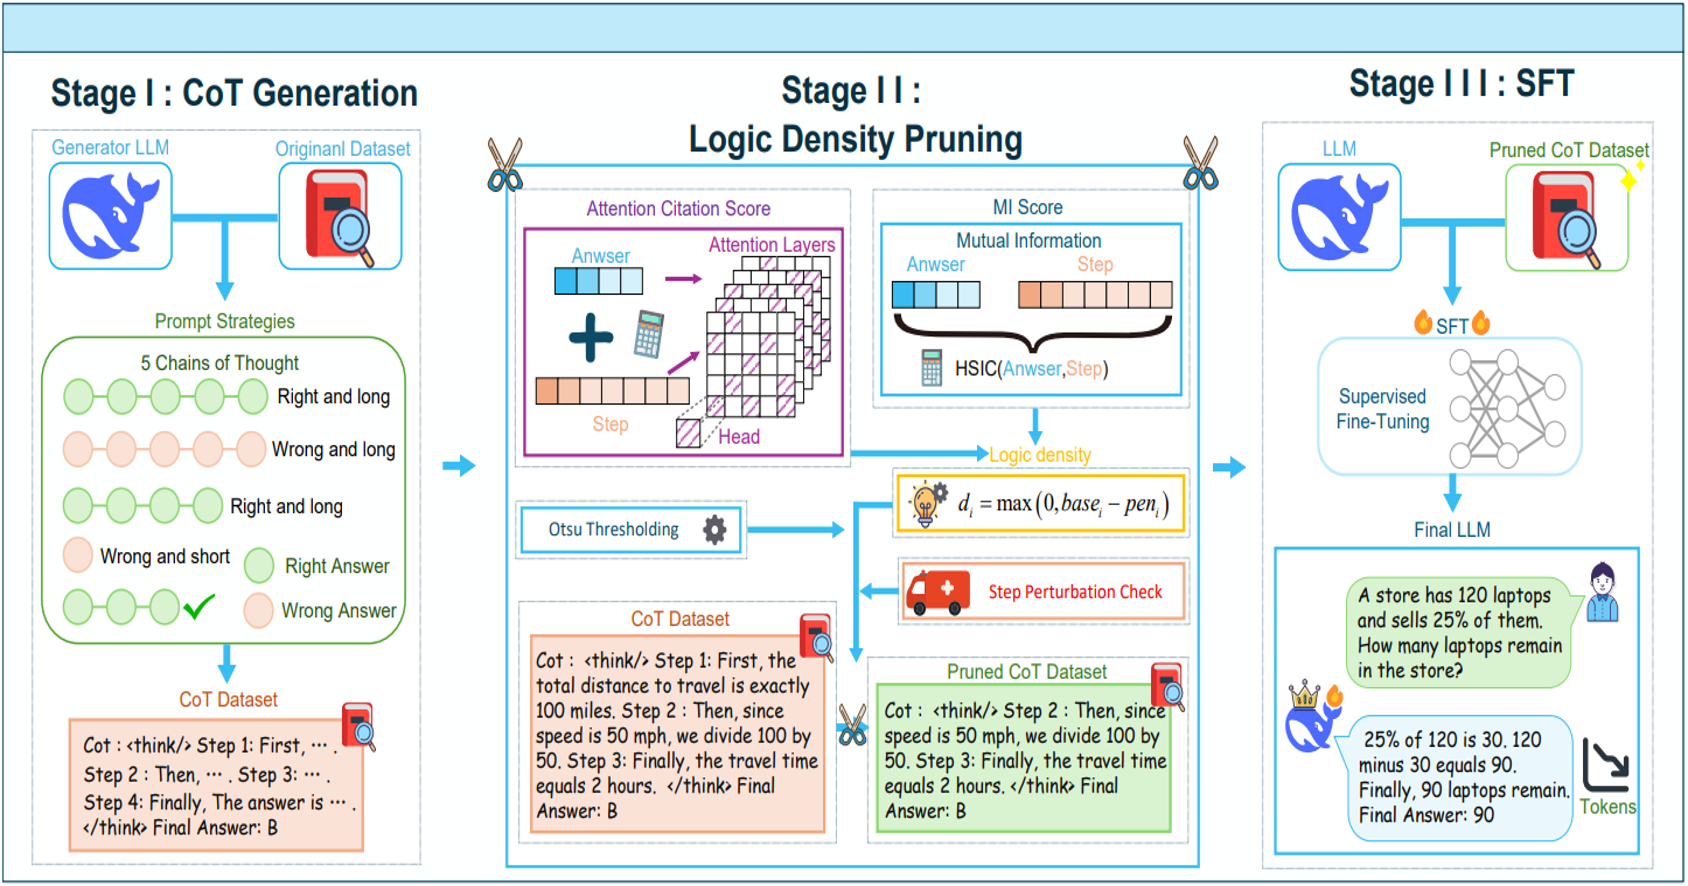
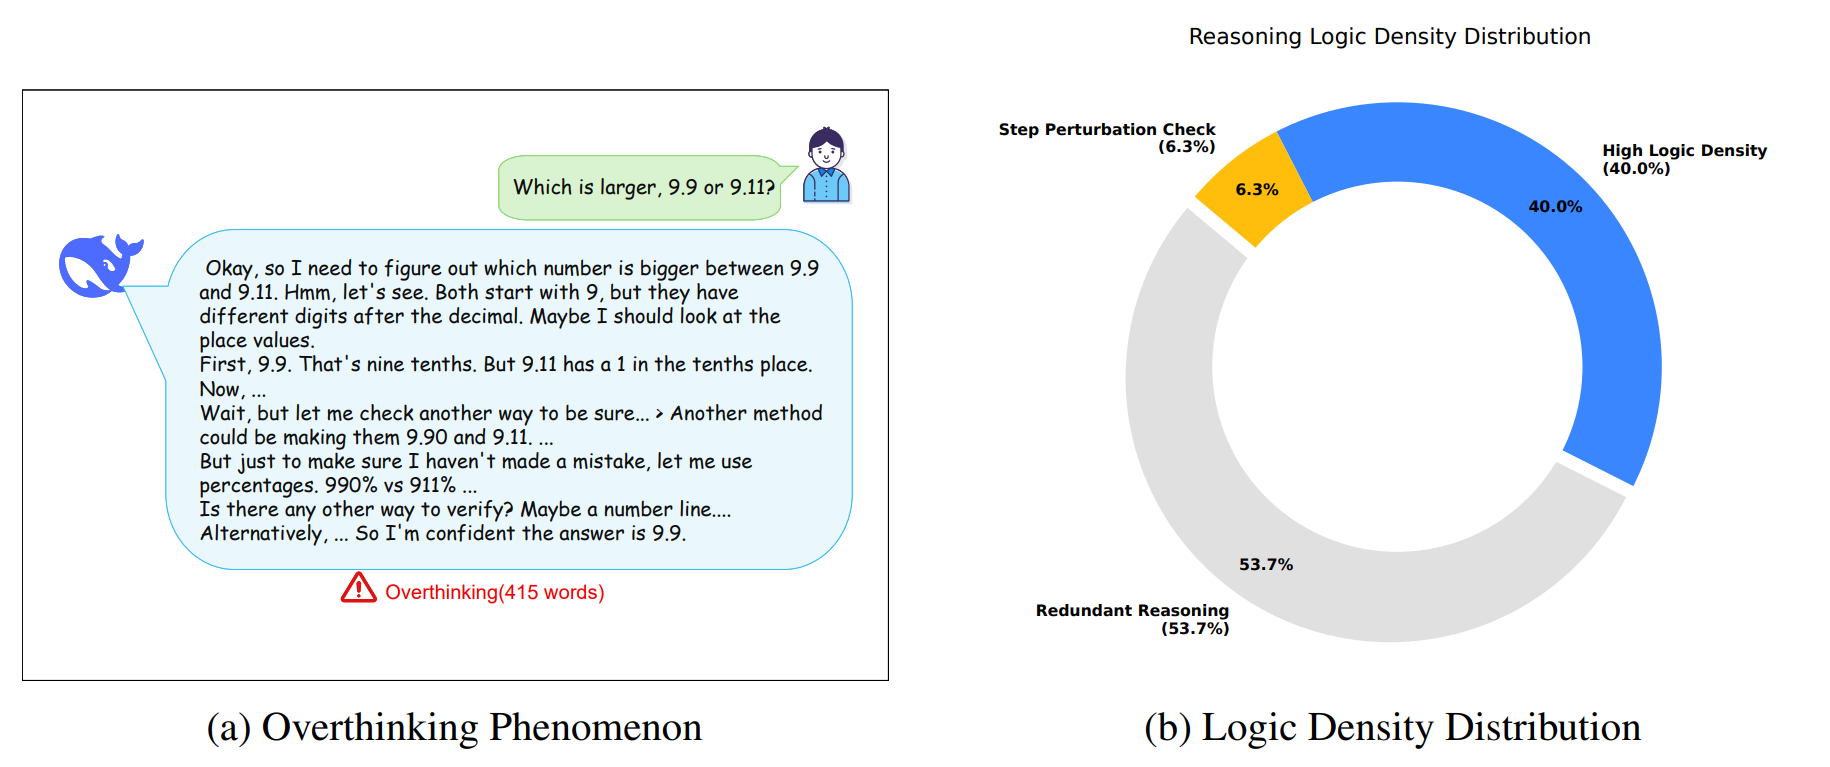
大语言推理模型在复杂任务中往往通过生成更长的思维链来提升表现,但冗余复述、松散解释和无效分支也会显著推高 token 消耗与推理延迟。针对这一“过度思考”现象,本文提出逻辑密度剪枝(LDP)框架,以互信息(MI)和注意力引用两类信号联合衡量推理步骤对最终答案的贡献,得到可解释的步骤重要性指标。
在剪枝阶段,LDP 使用 Otsu 自适应阈值完成样本内筛选,并通过步级微扰检查验证删除候选步骤是否会显著改变后续生成分布,对关键步骤进行选择性恢复;压缩后的思维链进一步作为监督数据用于微调,形成从剪枝、数据构建到训练的完整流程。在 CommonsenseQA 上应用于 Qwen3-8B 时,推理 token 从 295.5 降至 58.6,减少 80.2%,性能仅下降 1.9%。
80.2%Qwen3-8B Token 减少
-1.9%准确率变化
+3.5 ppDeepscaleR 准确率提升
我的贡献 在远程服务器中完成 Qwen3 与 DeepscaleR 多分支思维链生成、提取和清洗;使用 Python 批量计算基于希尔伯特-施密特独立性准则的互信息得分,统计“犹豫标记”与“结论标记”的词频分布;主导单一 MI、单一注意力指标的消融实验,并完成 TokenSkip、SBT 等基线的对比训练。DeepscaleR-1.5B 的 Token 消耗降低 49.2%,准确率由 40.8% 提升至 44.3%。
1 / 2